지도학습의 대표적인 분류(Classification) 알고리즘을 활용해 스팸 메일을 분류하는 서비스/프로그램을 만드는 과정과 실제 파이썬 코드를 설명해 드립니다.
스팸 메일 분류는 텍스트 형태의 비정형 데이터를 컴퓨터가 이해할 수 있는 수치형 데이터로 변환하는 '텍스트 전처리 및 벡터화' 과정이 핵심입니다.
1. 스팸 메일 분류 시스템의 전체 흐름
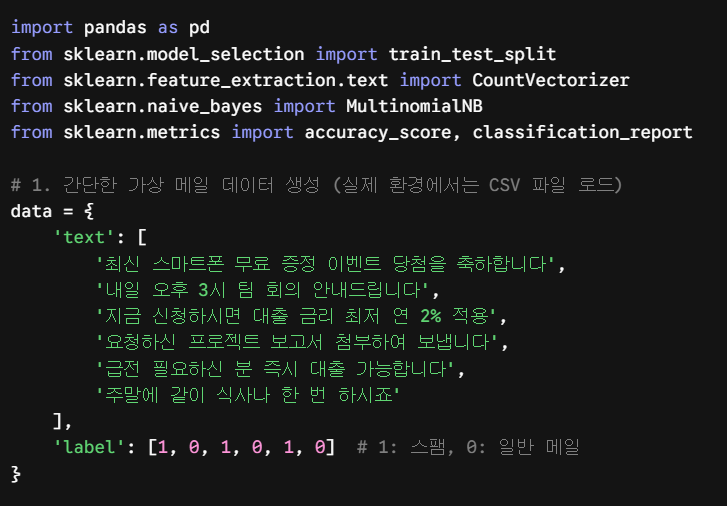
- 데이터 수집 및 전처리: 메일 텍스트 데이터(본문/제목)와 라벨(스팸: 1, 일반 메일: 0) 준비
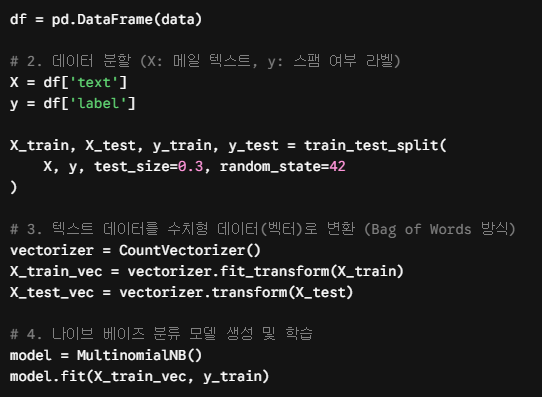
- 특징 추출 (Vectorization): 텍스트를 숫자로 변환 (예: Bag of Words, TF-IDF)
- 데이터 분할: 학습용(Train) 데이터와 검증용(Test) 데이터로 분할
- 모델 학습: 나이브 베이즈(Naive Bayes) 또는 로지스틱 회귀(Logistic Regression) 알고리즘 적용
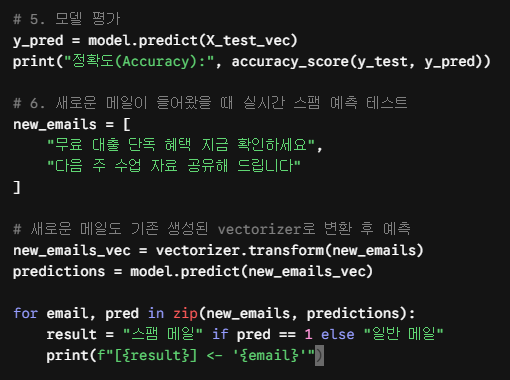
- 평가 및 예측: 새로운 메일이 들어왔을 때 스팸 여부 판단
2. 스팸 분류에 주로 사용되는 대표 알고리즘
- 나이브 베이즈 (Naive Bayes - MultinomialNB):
- 베이즈 정리(Bayes' Theorem)에 기반한 확률적 분류 알고리즘입니다.
- "무료", "당첨", "입금", "대출" 같은 특정 단어가 들어있을 때 해당 메일이 스팸일 확률을 계산하는 데 매우 강력하고 빠릅니다. (스팸 필터링의 가장 대표적인 클래식 알고리즘)
- 로지스틱 회귀 (Logistic Regression):
- 각 단어에 가중치를 부여하여 스팸일 확률(0~1 사이)을 계산하는 시그모이드(Sigmoid) 함수 기반 분류기입니다.
3. 파이썬(scikit-learn) 실전 구현 예제
아래는 scikit-learn 라이브러리의 CountVectorizer(텍스트 벡터화)와 MultinomialNB(나이브 베이즈 알고리즘)를 활용한 간단한 스팸 분류 구현 코드입니다.
4. 수업 및 프로젝트 확장 아이디어
학생들과 함께 이 수업이나 실습 프로젝트를 진행할 때는 다음과 같은 방향으로 고도화해 볼 수 있습니다.
- TF-IDF(Term Frequency-Inverse Document Frequency) 활용:
- 단순히 단어의 빈도수만 세는 CountVectorizer 대신, 문맥상 너무 흔하게 등장하는 단어(예: '입니다', '합니다')의 가중치를 낮춰주는 TfidfVectorizer를 적용하여 정확도를 향상시킬 수 있습니다.
- 형태소 분석기(KoNLPy) 결합:
- 한국어 특성상 조사나 어미를 분리해 주는 형태소 분석기(Mecab, Okt 등)를 적용해 불용어(Stopwords)를 제거하는 전처리를 수행하면 정교함이 더해집니다.
- 성능 평가 지표 확충:
- 단순 정확도(Accuracy) 외에도, 정밀도(Precision)와 재현율(Recall)의 개념을 가르치기에 좋은 예시입니다.
- 예: 일반 메일을 스팸으로 잘못 분류해서 안 읽히는 위험(FP)과 스팸을 일반 메일함으로 보낼 위험(FN) 중 어느 것이 더 치명적인가?
'26년2학기' 카테고리의 다른 글
| 목둘레, 허리둘레 .. gemini (0) | 2026.10.14 |
|---|---|
| 목둘레-허리둘레 예측과 같은 상관관계 예시 비교 질 (0) | 2026.10.14 |
| 진학·진로·직업-역할 부여를 했을 때, ChatGPT (0) | 2026.09.02 |
| 진학·진로·직업-역할 부여를 하지 않았을 때, ChatGPT (0) | 2026.09.02 |
| 알렉사 vs. 자비스 (0) | 2026.08.28 |