딥러닝 이전의 기계학습 vs 딥러닝 — 무엇이 근본적으로 달라졌는가
결론부터 말하면, 두 패러다임의 차이는 "표현(특징)을 사람이 설계하는가, 모델이 스스로 학습하는가" 한 축으로 수렴합니다. 알고리즘 목록의 차이가 아니라, 데이터에서 의미 있는 표현을 누가 만들어내는가라는 책임 소재의 이동입니다.
1. 정의
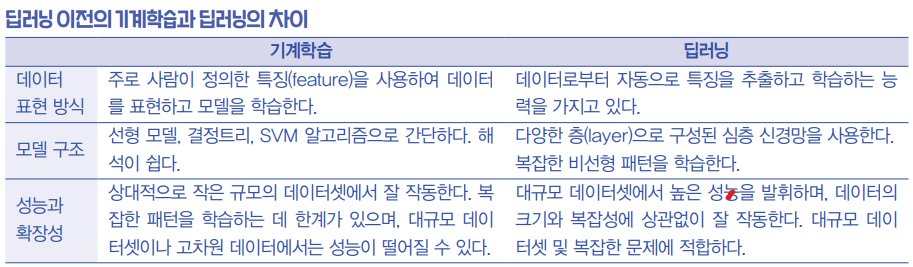
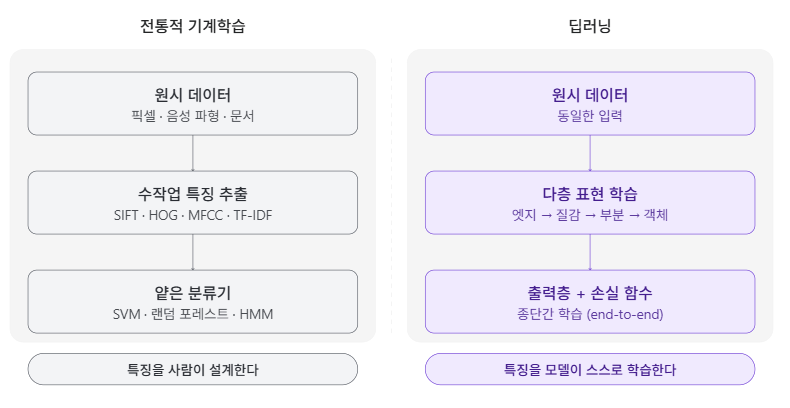
전통적 기계학습(딥러닝 이전, 대략 1990~2011년 주류) 원시 데이터를 사람이 설계한 특징(feature)으로 변환한 뒤, 그 특징 벡터 위에 얕은(shallow) 통계적 학습기를 얹는 방식입니다. 특징 설계와 분류기 학습이 분리된 두 단계이며, 각 단계가 독립적으로(그리고 국소적으로) 최적화됩니다. 대표적으로 SVM, 랜덤 포레스트, 로지스틱 회귀, 나이브 베이즈, GMM-HMM, CRF가 있습니다.
딥러닝(2012년 이후) 원시 데이터를 여러 층의 비선형 변환에 통과시켜 표현 자체를 학습합니다. 얕은 층의 단순 패턴이 깊은 층에서 점점 추상적인 개념으로 조합되며, 전체 파이프라인이 미분 가능한 하나의 함수로 묶여 오차역전파로 동시에(end-to-end) 학습됩니다. 대표적으로 CNN, RNN/LSTM, Transformer가 있습니다.
위에 제시한 도식이 이 차이를 그대로 보여줍니다. 왼쪽(전통)은 원시 데이터 → 수작업 특징 추출 → 얕은 분류기, 오른쪽(딥러닝)은 원시 데이터 → 다층 표현 학습 → 출력층으로, 오른쪽에는 사람이 개입하는 칸이 아예 없습니다.
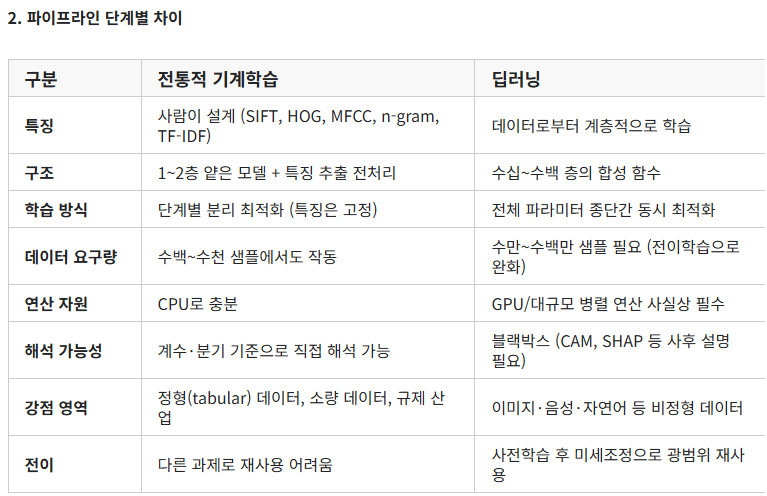
특징 공학이 왜 병목이었나. SIFT나 MFCC 같은 기술자는 뛰어난 공학적 성취였지만, 사람이 "무엇이 중요한 정보인지"를 미리 정해버립니다. 예컨대 얼굴 인식용 특징을 설계한 전문가가 고양이 분류에는 쓸모없는 특징을 만들어내는 식입니다. 게다가 특징 추출기와 분류기가 따로 최적화되므로, 분류기 입장에서 최적인 표현과 실제로 주어진 표현이 어긋날 수 있습니다. 딥러닝은 이 두 단계를 하나의 손실 함수로 묶어 "분류에 유리한 표현"을 손실이 직접 요구하도록 만듭니다.
딥러닝은 특징을 안 쓰는 게 아닙니다. CNN의 지역성·이동 불변성 가정, Transformer의 어텐션은 여전히 사람이 설계한 귀납 편향(inductive bias)입니다. 달라진 것은 "특징의 내용"이 아니라 "특징을 만드는 규칙"만 사람이 정하고, 그 규칙 안의 구체적 표현은 데이터가 채운다는 점입니다.
깊이가 주는 이점. 보편근사정리(universal approximation theorem)에 따르면 얕은 신경망도 임의의 연속 함수를 근사할 수 있지만, 특정 함수족에서는 같은 표현력을 얻는 데 필요한 뉴런 수가 깊이에 따라 지수적으로 늘어날 수 있습니다. 즉 깊이는 표현력의 문제라기보다 표현 효율성의 문제입니다.
3. 사례별 비교
3-1. 이미지 인식 — SIFT/Fisher 벡터 + SVM vs CNN
가장 극적인 반전이 일어난 분야입니다. 딥러닝 직전까지 ImageNet 대회(ILSVRC)의 우승 기법은 SIFT 등 국소 특징을 Fisher 벡터로 압축 부호화한 뒤 선형 SVM으로 분류하는 조합이었습니다.
- 2010년 우승: 오류율 약 0.28 (28% 수준) — SVM 계열 NVIDIA
- 2011년 우승: 압축 Fisher 벡터(SIFT + 색상 특징) + SVM, top-5 오류율 25.7% UTK-EECS 강의자료, ImageNet 공식 결과
- 2012년 AlexNet: 8층 CNN(5개 합성곱층 + 3개 완전연결층), top-5 오류율 15.3%로 우승, 2위(26.2%)와 10%p 이상 차이 Krizhevsky et al., NeurIPS 2012, Wikipedia: AlexNet
- 같은 논문에서 ILSVRC-2010 테스트셋 기준 top-1 오류율 37.5%, top-5 17.0%를 기록했으며, 이는 당시 최고 성능을 크게 앞선 값이었습니다 Krizhevsky et al., 2012
- 2015년 ResNet: 152층 잔차 네트워크 앙상블로 top-5 오류율 3.57%, ILSVRC 2015 우승 He et al., CVPR 2016
주목할 점은 25.7% → 15.3% → 3.57%라는 낙폭이 알고리즘 아이디어의 개선 폭이라기보다 표현 학습 방식의 교체에서 나왔다는 사실입니다. AlexNet의 승리는 합성곱층이 스스로 학습한 필터가 1층에서는 에지·색 대비, 중간층에서는 질감·부분 형태, 상위층에서는 객체 전체에 대응하는 계층적 특징을 만들어낸다는 것을 보여줬습니다. 같은 데이터, 같은 과제, 같은 평가 지표인데 사람이 설계한 특징을 모델이 학습한 특징이 압도한 것입니다. (일반적으로 인용되는 인간 top-5 오류율 약 5% 수준보다도 ResNet 앙상블의 3.57%가 낮다는 점이 자주 언급됩니다.)
3-2. 음성 인식 — GMM-HMM vs DNN-HMM / RNN
음성은 이미지보다 먼저 딥러닝이 실전 성과를 낸 분야입니다. 2012년 Hinton 등이 Switchboard 데이터셋에서 GMM-HMM 기반 기준 시스템의 단어 오류율(WER) 27.4%를 DNN으로 18.5%까지 낮춰, 33%의 상대적 오류 감소를 보고했습니다 Hinton et al., 2012.
구조적으로 무슨 일이 일어난 것인지가 중요합니다. 기존 시스템은 관측 음향을 GMM(가우시안 혼합 모델)으로 확률화하고 은닉 마르코프 모델로 시간 축을 다루는, 음향 모델과 언어 모델과 발음 사전이 분리된 파이프라인이었습니다. 하이브리드 DNN-HMM은 그중 GMM 자리를 심층망으로 교체했고, 이후 CTC·어텐션 기반 종단간 모델로 발전하며 파이프라인 자체가 하나의 신경망으로 흡수되었습니다. 사전학습(층별 무감독 사전학습)과 GPU 병렬화가 이 전환의 실질적 촉매였다는 점도 자주 강조됩니다.
3-3. 자연어 처리 — TF-IDF/BoW + 나이브 베이즈 vs 워드 임베딩·Transformer
- 전통 방식: 문서를 TF-IDF나 bag-of-words 벡터로 바꾸고 나이브 베이즈나 선형 SVM을 적용합니다. 스팸 필터링, 초기 감성 분석에서 매우 강력했고 — 지금도 데이터가 적은 텍스트 분류의 강력한 베이스라인입니다. 다만 어휘가 늘면 차원이 폭발하고, "은행(bank)이 강둑인지 금융기관인지" 같은 문맥 의미를 담지 못하며, 단어 순서를 n-gram으로 일부 우회할 뿐입니다.
- 딥러닝 방식: 단어를 학습된 밀집 벡터(분산 표현)로 바꾸고, 시퀀스 모델로 문맥을 처리합니다. 2017년 Transformer는 WMT 2014 영어→독일어 번역에서 BLEU 28.4를 기록하며 기존 최고 성능(앙상블 포함)을 2 BLEU 이상 앞섰습니다 Vaswani et al., 2017. 순환 구조 없이 어텐션만으로 시퀀스를 처리한다는 발상은 이후 언어 모델 전반의 기반이 되었습니다.
핵심 차이는 "단어를 독립 기호로 취급하느냐, 문맥에 따라 변하는 벡터로 취급하느냐" 입니다. 전통 방식에서 단어는 어휘 집합의 인덱스일 뿐이지만, 임베딩 이후 단어는 학습되는 표현이며 이 표현 자체가 과제 성능을 좌우합니다.
3-4. 정형 데이터 — 여전히 그라디언트 부스팅이 이기는 영역
딥러닝이 모든 곳에서 이긴 것은 아닙니다. 이것이 "딥러닝이 항상 우월하다"는 통념을 반박하는 가장 중요한 사례입니다.
2022년 NeurIPS 벤치마크 연구는 약 1만 샘플 규모의 중간 크기 정형 데이터에서 트리 기반 모델(XGBoost, LightGBM, CatBoost 계열)이 학습 속도 이점을 제외하고도 여전히 최고 수준(SOTA) 이라고 보고했습니다. 저자들은 그 원인으로 트리 모델이 비회전 불변성(non-rotational invariance), 비평활·불연속 목표 함수 처리, 무관한 특징에 대한 강건성에서 구조적 이점을 가진다는 점을 지목합니다 Grinsztajn et al., 2022.
실무적으로도 신용평가, 사기 탐지, 의료 위험 예측, 설비 예측정비처럼 데이터가 정형 표 형태이고, 표본이 수천~수만 건이며, 규제기관이 "왜 이 결정을 내렸는가"를 요구하는 영역에서는 GBDT나 로지스틱 회귀가 기본 선택지입니다. 여기서 딥러닝의 약점은 정확도가 아니라 해석 가능성과 샘플 효율입니다.
4. 그렇다면 왜 2012년이었나 — 알고리즘이 아니라 조건의 변화
신경망 자체는 1950~80년대부터 존재했고, 역전파도 1986년에 정식화되었습니다. 2012년에 판이 뒤집힌 것은 세 조건이 동시에 충족되었기 때문입니다.
- 데이터: ImageNet(1000개 클래스, 약 120만 장 규모)이라는 대규모 라벨 데이터셋이 등장했습니다. 수작업 특징 공학의 천장은 데이터 양이 늘어도 올라가지 않지만, 표현 학습 모델의 성능은 데이터 양에 따라 계속 상승합니다.
- 연산: GPU 병렬 연산으로 수십 층 규모의 학습이 실용적 시간 안에 가능해졌습니다.
- 학습 기법: ReLU 활성화, 드롭아웃, 데이터 증강, 층별 사전학습 등이 결합되어 깊은 망의 학습 불안정성이 해소되었습니다.
즉 전환의 본질은 "표현 학습이 데이터 규모에 따라 이득을 보는 구조" 와 "그 규모를 감당할 연산·데이터가 갖춰진 시점" 의 만남이었습니다.
5. 정리 — 선택 기준
- 비정형 데이터(이미지·음성·텍스트·영상) + 충분한 데이터·연산 → 딥러닝. 표현 학습의 이득이 압도적입니다.
- 정형 데이터 + 중소 규모 표본 + 해석 가능성 요구 → 전통 ML(GBDT, SVM, 로지스틱). 특히 1만 건 규모 이하에서는 여전히 트리 기반이 안전한 기본값입니다.
- 데이터가 극히 적음 → 전통 ML 또는 사전학습 모델의 미세조정. 처음부터 딥러닝을 학습시키는 것은 비효율적입니다.
- 엣지·저전력·저지연 환경 → 경량 전통 모델이 여전히 실용적입니다.
- 경계는 흐려지고 있습니다. 전이학습과 파운데이션 모델은 "샘플 효율"이라는 딥러닝의 최대 약점을 상당 부분 상쇄했고, 정형 데이터용 딥러닝 아키텍처(예: TabNet 계열)도 계속 연구되고 있습니다.
핵심 한 줄: 전통 ML은 사람이 표현을 알고리즘에 넘겨주고, 딥러닝은 그 표현을 데이터에서 찾아냅니다. 어느 쪽이 옳다기보다, 표현을 사람이 더 잘 만들 수 있는지(도메인 지식이 명확하고 데이터가 적을 때) 데이터가 더 잘 만들 수 있는지(데이터가 많고 표현이 복잡할 때)에 따라 선택이 갈립니다.
참고 문헌
- Krizhevsky, Sutskever & Hinton, "ImageNet Classification with Deep Convolutional Neural Networks" (NeurIPS 2012)
- He et al., "Deep Residual Learning for Image Recognition" (CVPR 2016)
- Hinton et al., "Deep Neural Networks for Acoustic Modeling in Speech Recognition" (2012)
- Vaswani et al., "Attention Is All You Need" (2017)
- Grinsztajn, Oyallon & Varoquaux, "Why do tree-based models still outperform deep learning on tabular data?" (NeurIPS 2022)
- ILSVRC 2012 공식 결과 · Wikipedia: AlexNet
혹시 특정 축을 더 깊게 파보고 싶으시면 알려주세요. 예를 들어 커널 SVM과 얕은 신경망의 이론적 관계, 전이학습이 샘플 효율 문제를 어떻게 완화하는지, 또는 해석 가능성 요구가 강한 금융·의료에서의 모델 선택 가이드 같은 주제로 더 들어갈 수 있습니다.
'26년2학기' 카테고리의 다른 글
| 딥러닝 이전의 기계학습과 딥러닝의 차이 ... chatgpt (0) | 2026.10.16 |
|---|---|
| 지도학습 - 분류 ... grmini (0) | 2026.10.14 |
| 목둘레, 허리둘레 ... gemini (0) | 2026.10.14 |
| 목둘레-허리둘레 예측과 같은 상관관계 예시 비교 질 (0) | 2026.10.14 |
| 진학·진로·직업-역할 부여를 했을 때 ... ChatGPT (0) | 2026.09.02 |